비용은 알겠는데, 성능은 어떨까? 최신 VLM과 직접 비교한 PyMuPDF Office
"그래서, 성능은요?"
지난 글에서는 GPU 서버 없이 CPU 파서만으로 RAG 문서 처리 비용을 줄이는 방법을 소개했습니다.
비용 이야기 뒤에는 자연스럽게 다음 질문이 따라옵니다. "그래서, 성능은요?"
그래서 이파피루스와 Artifex가 직접 비교해봤습니다. 상대는 최신 VLM(Vision Language Model)인 GPT-6 Astra입니다. 같은 문서를 두고 비교한 결과, PyMuPDF Office는 GPU 없이 CPU만으로도 최신 VLM과 대등한 레이아웃 정확도를 보였고, 처리 속도는 훨씬 빨랐습니다.
비교는 이렇게 했습니다
기준은 문서 파싱 벤치마크 ParseBench입니다. GPT-6 Astra는 ParseBench 리더보드와 동일한 설정으로 실행했고, 같은 문서에 대한 PyMuPDF Office의 결과와 비교했습니다. 속도와 비용은 30페이지 샘플로 측정했고, PyMuPDF Office는 GPU 없이 CPU만 사용했습니다.
점수에 더해, 차이가 실제 문서에서 어떻게 드러나는지 세 가지 사례로 보여 드리겠습니다.
대형 표 — 같은 정답, 259초 vs 7.8초
첫 사례는 셀이 3,267개나 되는 대형 표입니다. 작은 숫자가 페이지 전체를 빽빽하게 채우고 있습니다.
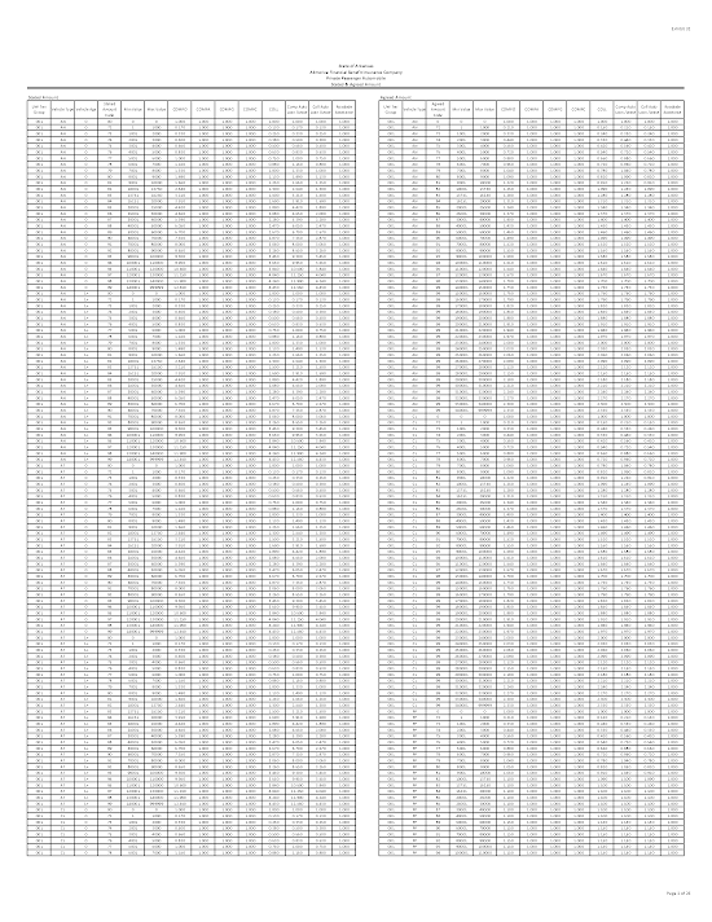
두 제품 모두 3,267개 셀 값을 정확하게 추출했습니다. 갈린 것은 시간과 비용입니다.
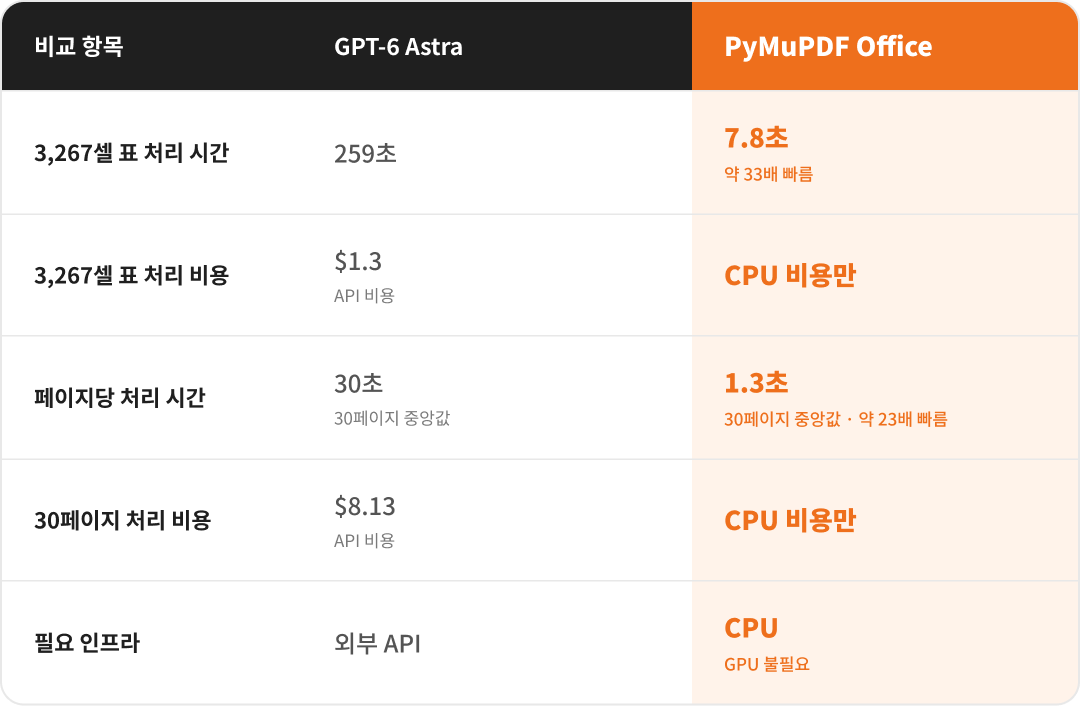
PyMuPDF Office는 7.8초 만에 끝냈고, GPT-6 Astra는 259초가 걸렸습니다. Astra는 이 표 한 장에 API 비용 $1.3을 썼습니다.
이 격차는 대형 표에만 해당하는 이야기가 아닙니다. 30페이지 샘플 전체로 넓혀 보면, 페이지당 처리 시간(중앙값)은 PyMuPDF Office가 1.3초, GPT-6 Astra가 30초였습니다.
30페이지를 처리하는 데 Astra는 API 비용 $8.13을 썼고, PyMuPDF Office는 CPU 비용만 들었습니다.
두 결과를 한눈에 정리하면 다음과 같습니다.
페이지당 처리 시간으로 단순 계산하면, 1만 페이지를 차례로 처리할 때 GPT-6 Astra는 약 83시간, PyMuPDF Office는 약 3.6시간이 걸립니다.
문서가 계속 쌓이는 RAG 파이프라인에서는 이 차이가 곧 새 문서가 검색에 반영되는 속도입니다.
물론 ParseBench의 벤치마크상 표 항목 전체 점수는 GPT-6 Astra가 앞섰습니다(93.2점 vs 72.0점). 하지만 이번 사례처럼 두 제품이 모두 정답을 내는 표라면, 승부는 속도와 비용에서 갈립니다.
레이아웃 정확도 — 최신 VLM보다 정밀한 좌표
레이아웃 파싱은 벤치마크상으로도 PyMuPDF Office가 GPT-6 Astra보다 높은 점수를 받았습니다. GPU 없이 CPU만 쓰고 얻은 결과입니다.
이 차이가 실제 문서에서는 어떻게 나타나는지 두 사례로 살펴보겠습니다.
각 사례의 그림에서 녹색 점선은 사람이 직접 표시한 정답 영역(Ground Truth), 파란색은 GPT-6 Astra, 보라색은 PyMuPDF Office가 찾은 영역입니다.
사례 ① 이사회 소개 페이지 — 좌표의 일치 여부
사진, 이름, 약력, 위원회 범례가 촘촘하게 배치된 페이지입니다.
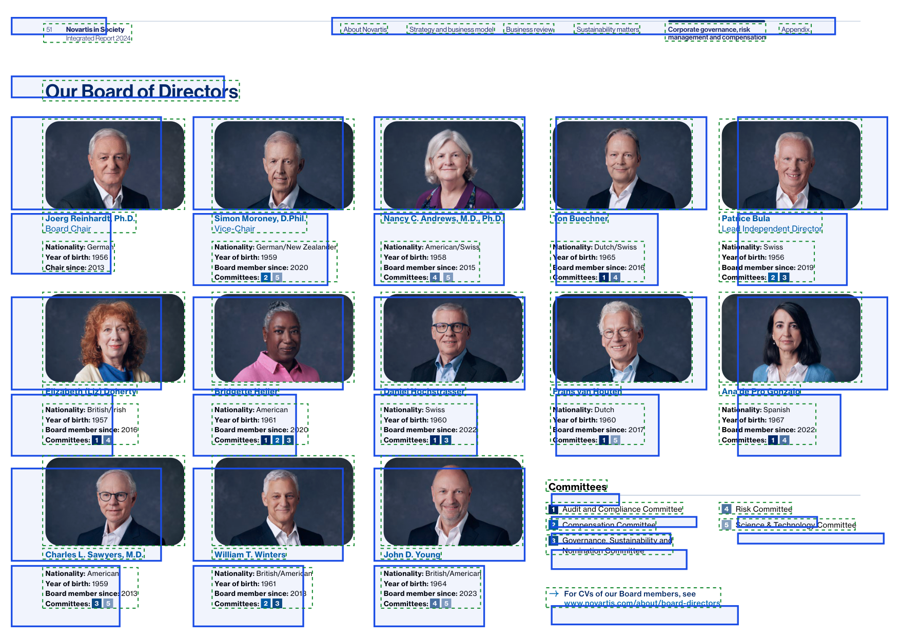
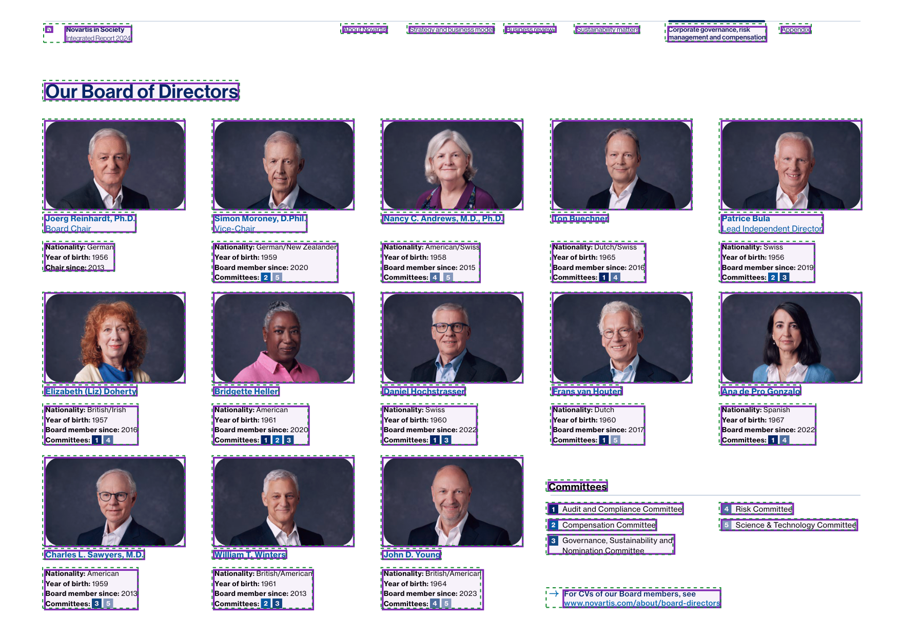
PyMuPDF Office는 작은 영역을 하나하나 정답과 거의 같은 위치에서 잡아냈습니다. GPT-6 Astra에서는 세 가지 오류가 보였습니다.
- 좌표 어긋남 — 사진과 약력 박스가 실제 위치보다 왼쪽으로 밀리거나 크기가 맞지 않았습니다.
- 영역 뭉뚱그림 — 상단의 페이지 번호와 제목을 하나의 박스로, 메뉴 항목 6개를 또 하나의 박스로 합쳤습니다. 둘째 줄의 이름도 사진 영역에 묶었습니다.
- 영역 누락 — 우측 하단 위원회 범례는 박스가 빈 곳에 찍혔고, 일부 항목은 잡지 못했습니다.
RAG에서 좌표는 답변의 근거가 문서 어디에 있는지 가리키는 출처 정보입니다. 좌표가 어긋나면 출처 표시도 엉뚱한 곳을 가리킵니다.
사례 ② 재무 스케줄 — 각주 인식
재무 스케줄 페이지에서 GPT-6 Astra는 표 아래 각주 2개와 페이지 번호(S-1)를 찾지 못했습니다. PyMuPDF Office는 표, 각주, 페이지 번호를 모두 정답 위치에서 잡아냈습니다.
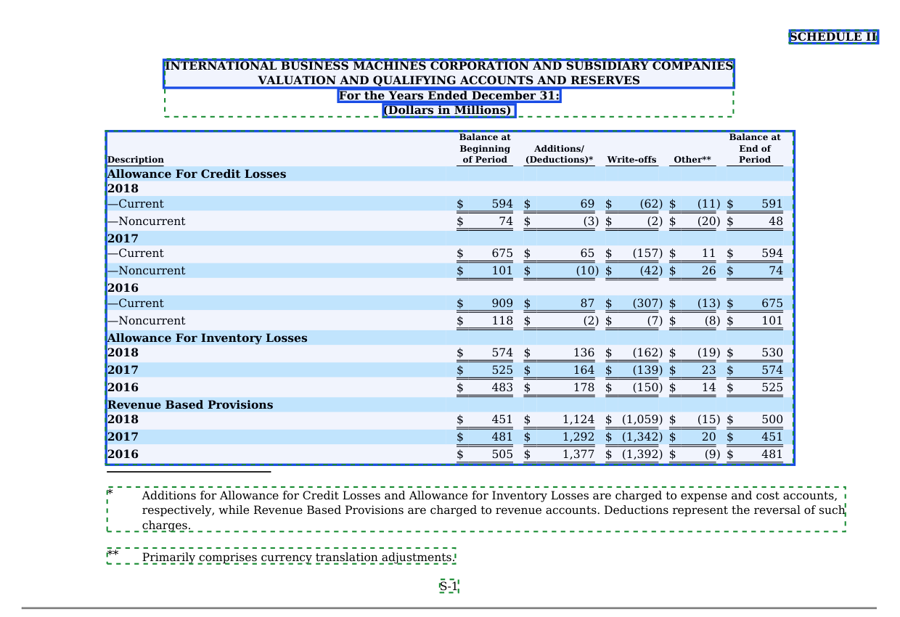
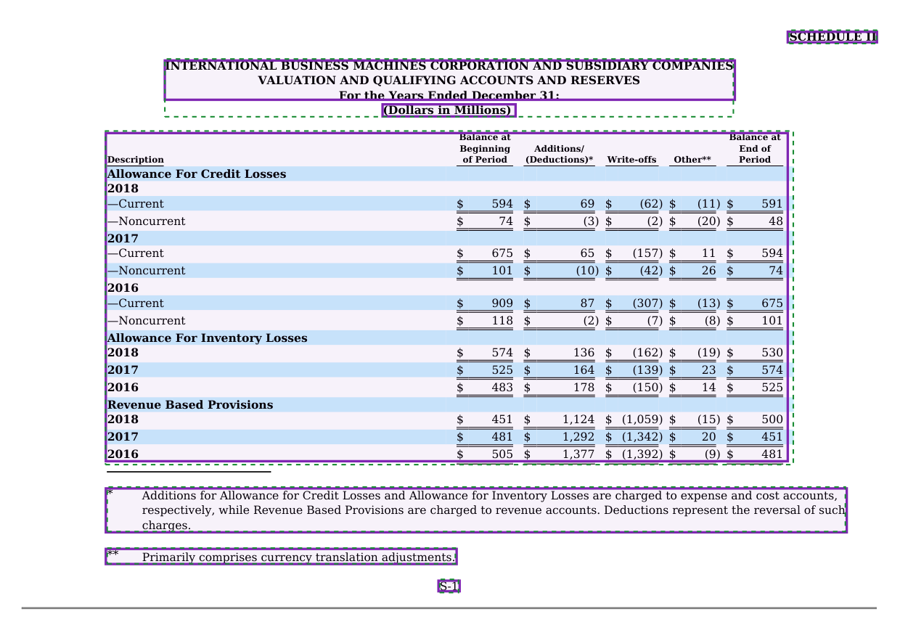
재무제표의 각주는 숫자가 어떤 회계 기준으로 처리되었는지 설명하는 핵심 정보가 담겨 있습니다.
RAG나 문서 분석 파이프라인에서 각주가 빠지면, 답변은 숫자만 있고 그 근거는 없게 됩니다.
차이는 어디서 나올까?
이렇게 물을 수도 있습니다. "VLM에도 문서 텍스트를 함께 넣어 주면 되지 않나요?" 사실 이미 그렇게 하고 있습니다. 리더보드 상위 VLM들은 PDF 파일을 그대로 입력받고, API가 PDF의 텍스트 레이어를 추출해 페이지 이미지와 함께 모델에 넣는다고 설명하고 있습니다.
그런데도 속도는 수십 배 느렸고, 좌표는 어긋났습니다. 이유는 문서를 대하는 방식에 있습니다.
병원의 CT 판독을 떠올려 볼까요? 같은 CT 영상을 받아도, 여러 분야를 두루 보는 의사는 눈에 띄는 이상을 찾아내고, 영상 판독 전문의는 작은 그림자 하나까지 정확한 위치로 짚어 냅니다. 받은 내용은 같지만, 판독의 정밀도가 다르기 때문입니다. 문서도 마찬가지입니다. VLM과 PyMuPDF Office는 같은 PDF를 받지만, 결국 결과를 가르는 것은 문서 내부 구조를 얼마나 정밀하게 해석하느냐입니다. 이것이 수십 년간 문서 엔진을 만들어 온 이파피루스와 Artifex의 기술력이기도 합니다.
정확하게 읽어야, AI도 정확하게 답합니다
문서를 다루는 RAG·AI 파이프라인이라면, 문서를 읽는 단계까지 비싼 VLM에 맡길 필요는 없습니다. 특히 그 과정이 느리고, 정확성마저 떨어진다면 더욱 그럴 필요가 없죠.
PyMuPDF Office를 쓰면 이런 점이 달라집니다.
- 처리량 — 페이지당 1.3초. 문서가 계속 쌓이는 환경에서도 전처리에 드는 시간을 크게 줄일 수 있습니다.
- 비용 — 페이지마다 쌓이는 API 비용 없이, CPU만으로 최신 VLM 못지않은 레이아웃 품질을 냅니다.
- 정확도 — 각주와 페이지 번호 같은 작은 영역까지 정확한 위치에서 찾아, AI 답변의 근거를 제대로 짚어 줍니다.
- 배포 유연성 — 외부 API가 필요 없어, 문서를 밖으로 내보낼 수 없는 온프레미스 환경에서도 쓸 수 있습니다.
AI 모델이 아무리 똑똑해도, 읽어 들인 문서가 정확하지 않으면 답도 정확할 수 없습니다. 각주 하나가 빠지면 숫자의 근거가 사라지고, 좌표가 어긋나면 출처 표시도 엉뚱한 곳을 가리킵니다. 그래서 AI가 똑똑해질수록, 문서를 정확하게 읽어 건네는 엔진의 가치는 오히려 커집니다. 문서는 PyMuPDF Office가 빠르고 정확하게 읽고, AI는 그 위에서 이해와 추론에 집중하는 것, 이것이 가장 효율적인 조합입니다.
PyMuPDF를 사용하시면서 궁금한 점이나 공유하고 싶은 내용이 있다면, Discord 채널과 포럼을 방문해보세요.
👉🏻PyMuPDF Discord 채널 참여하기
👉🏻 PyMuPDF 포럼 방문하기
🎉 Happy Coding! 🙂
CPU 기반의 데이터 추출 도구(파서) PyMuPDF에 대해 더 궁금하시다면, 이파피루스 홈페이지를 방문해주세요!
👉 문서 데이터 추출 파이썬 라이브러리 PyMuPDF Office
-
조달청 디지털서비스몰 등록 제품 (물품식별번호: 26238849)
-
간단한 정보 입력으로 즉시 발급받는 60일 무료 체험 키 지원